Dataceen og arkitektur
Ta gjerne en titt på seksjonen med ofte stilte spørsmål — der finner du svar på vanlige spørsmål som kan være av interesse.
Fem måter å kjøre det på
Modellen er den samme i alle fem. Det som endres, er hvem som kjører plattformen og hvor dataene ligger.
Hosted
- Hvem som kjører plattformen
- Dataceen
- Hvor dataene ligger
- En database og en søkeindeks driftet av Dataceen, i en region vi har åpen
- Hvem sin skykonto
- Dataceens
- Hva du tar med
- Ingenting
Hosted, your database
- Hvem som kjører plattformen
- Dataceen
- Hvor dataene ligger
- En database og en søkeindeks du kontrollerer
- Hvem sin skykonto
- Dataceens for plattformen, din for dataene
- Hva du tar med
- En støttet database og en Elasticsearch-installasjon
Dedicated
- Hvem som kjører plattformen
- Dataceen
- Hvor dataene ligger
- Databaseservere for bare din bedrift
- Hvem sin skykonto
- Dataceens
- Hva du tar med
- Ingenting
Dedicated, in your cloud
- Hvem som kjører plattformen
- Dataceen, inne i kontoen din
- Hvor dataene ligger
- I din egen konto
- Hvem sin skykonto
- Din
- Hva du tar med
- En skykonto på Azure, AWS eller Google Cloud
Self-run
- Hvem som kjører plattformen
- Du. Vi setter det opp sammen med deg
- Hvor dataene ligger
- Hos deg
- Hvem sin skykonto
- Din
- Hva du tar med
- Egne kontoer for de eksterne tjenestene det bruker, som KI og kart
Regioner. Hosted og Hosted, your database kjører i regionene vi har åpne, EU som standard. Dedicated, Dedicated in your cloud og Self-run kan ligge i hvilken som helst region på Azure, AWS eller Google Cloud.
Søkeindeksen følger databasen. Når du kontrollerer databasen, kontrollerer du også søkeindeksen. Ingen kopi av postene dine ligger hos Dataceen.
Lese dataene dine direkte. Med Dedicated og oppover kan rapport- og analyseverktøyene dine lese databasen direkte. Endringer bør gå gjennom API-et: det er der modellens regler, tilgangene og kalloggen gjelder. Det som skrives rett inn i databasen, går utenom alle tre.
Self-run. Du får egne miljøer for utvikling, test og produksjon. De bruker dine egne kontoer for KI og for kart, og de fortsetter å kjøre uten forbindelse til Dataceen. Self-run lisensieres per år.
Lær mer om hvordan Dataceen fungerer
Forretningsdatamodellen
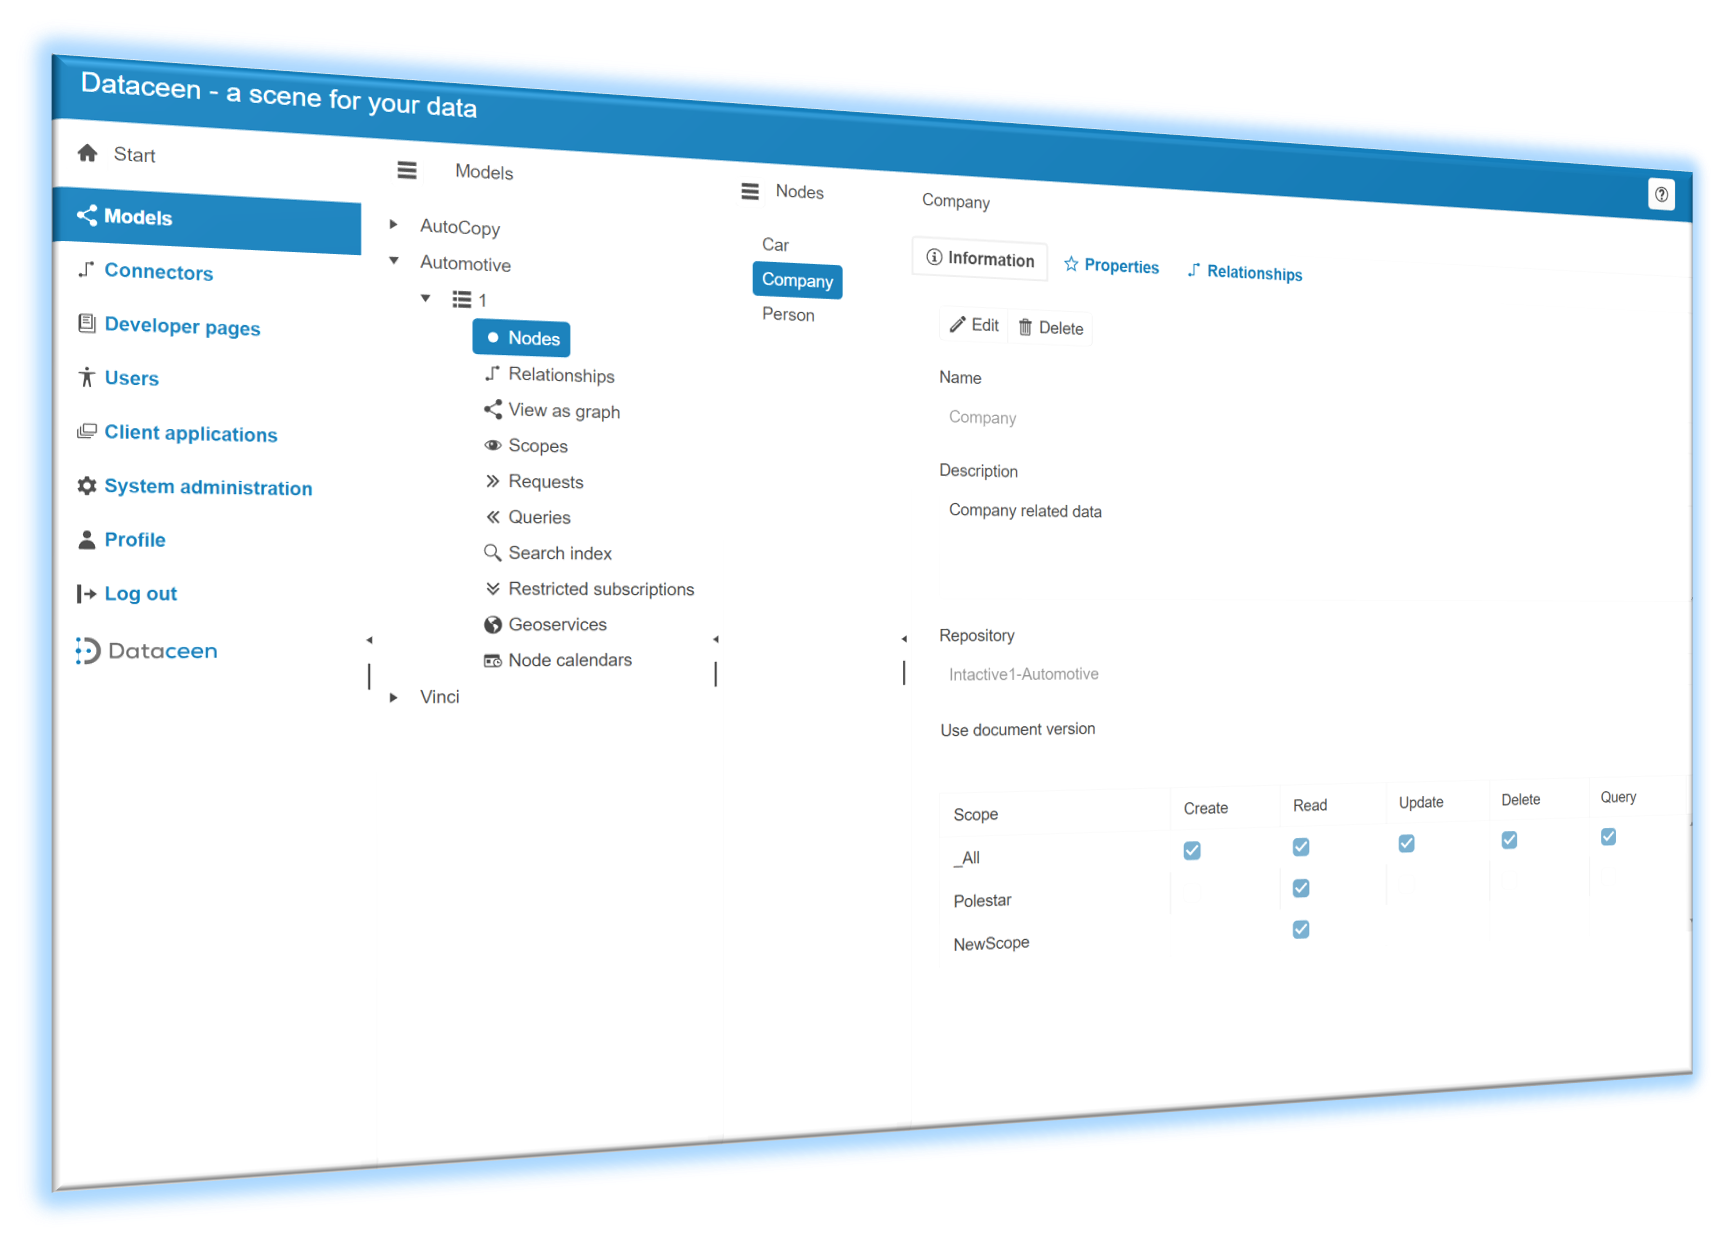
Forretningsdatamodellen er kjernen i Dataceen. Den definerer hvordan forretningsdata er strukturert og henger sammen, uavhengig av hvor dataene fysisk befinner seg. Den opprettes og forvaltes med Dataceens administrasjonsverktøy.
En modell beskriver hva forretningsdataene er og hvordan de henger sammen, uten hensyn til hvor dataene fysisk befinner seg. De faktiske dataene kan finnes i mange ulike systemer — som ERP, CRM, kjøretøyregistre, kundedatabaser eller andre masterdatakilder — men modellen gir ett samlet forretningsperspektiv. Dataceen kan inneholde et ubegrenset antall modeller, i ulik størrelse og kompleksitet.
En grafbasert struktur
Hver modell er strukturert som en graf, bestående av:
- Noder — representerer forretningsentiteter som kunde, kjøretøy, ordre, tekniker eller serviceavtale
- Relasjoner — beskriver hvordan entiteter henger sammen (f.eks. kunde eier kjøretøy eller tekniker utfører service)
- Egenskaper — attributter som beskriver noder eller relasjoner, som navn, registreringsnummer, servicedato eller status. Egenskaper kan hentes fra hvilket som helst masterdatasystem, slik at én node kan kombinere data fra flere systemer.
Grafstrukturen gir en tydelig og intuitiv fremstilling av forretningsdomenet, som gjør det enklere for både mennesker og systemer — inkludert KI — å forstå og jobbe med dataene.
Fleksibel modellering: KI, manuelt eller i kombinasjon
- KI-assistert modellering — KI kan analysere beskrivelser, dokumenter eller eksisterende datastrukturer og generere en første modell automatisk.
- Manuell design — Arkitekter og domeneeksperter kan bygge eller forbedre modeller manuelt i administrasjonsverktøyet, med full kontroll over struktur og betydning.
- Hybrid tilnærming — KI genererer den første strukturen, mens eksperter forbedrer, utvider og validerer modellen. Det gir rask utvikling uten å miste presis forretningskontroll.
Uansett hvordan modellen lages, er resultatet alltid en fullt kontrollert og transparent datastruktur som eies av virksomheten.
En kontrakt for dataintegrasjon
Forretningsdatamodellen fungerer som en kontrakt mellom systemer. Den definerer hvordan data fra ulike kilder integreres, tolkes og brukes på tvers av applikasjoner og tjenester. Fordi modellen vet nøyaktig hvilket system som eier hvert dataelement, vet Dataceen alltid hvor riktige data skal hentes fra.
Automatisk plattformgenerering
Når en modell er opprettet, genererer Dataceen fra den:
Sikkerhet og tilgangskontroll utledes også direkte fra modellen. Det betyr at forretningsdatamodellen ikke bare beskriver dataene — den driver hele Dataceen-plattformen og sikrer at alle systemer får tilgang til og bruker data på en konsistent, sikker og veldefinert måte.
Utfordringer arkitekter møter hver dag
Dataintegrasjon burde ikke være en fulltidsjobb. Likevel bruker arkitekter mesteparten av tiden på å løse de samme strukturelle problemene om og om igjen.
Fragmentert datalandskap
Forretningsdata er spredt over dusinvis av systemer uten en enhetlig modell. Hvert integrasjonsprosjekt starter fra null.
Integrasjonsprosjekter som tar måneder
Hvert nye databehov krever skreddersydde API-er, sikkerhetslag og dokumentasjon — alt bygget manuelt, hver gang.
Inkonsistent sikkerhet og styring
Tilgangskontroll er implementert forskjellig i hvert system. Det finnes ingen felles kilde til sannhet om hvem som har tilgang til hva.
Slik passer Dataceen inn i arkitekturen din
Dataceen sitter mellom systemene dere allerede kjører og applikasjonene, agentene og partnerne som konsumerer data. Hvert eksisterende system møtes på sine egne vilkår: erstattes, får noe foran seg, mater inn, mater ut eller beholdes bak en adapter.
ERP
CRM
BI Tools
Custom Systems
Dataceen
Felles datamodell · Automatisk generert infrastruktur
APIs
Security
Search
Documentation
Applikasjoner
Dashbord og BI
Partnerintegrasjoner
Applikasjoner bygges av teamet deres på SDK-et, eller bygges og driftes av Dataceen: et dashbord, et nettsted eller et oppgaveprogram, testet av en port og i drift på 10 til 40 minutter, med koden i et GitHub-repository dere kan ta over.
Fem måter å møte et eksisterende system på
Avgjort per system, ikke for hele landskapet.
Erstatt det
Dataene flytter inn i en modell; brukerne flytter til en ny applikasjon.
Sett noe foran
En ny applikasjon eller et nytt API foran, det gamle systemet bak.
Mat inn
Det gamle systemet kjører videre og mater modellen.
Mat ut
Modellen holder dataene; systemene som blir igjen følger den gjennom hendelser eller et SQL-speil.
Behold grensesnittet
En adapter serverer det gamle API-et eller filformatet én til én, så partnere endrer ingenting.
De fleste første prosjekter starter med mat inn pluss én ny applikasjon, og erstatter senere: lav risiko, verdi tidlig.
Laget for virkelige arkitekturer
Her er hva det betyr i praksis.
Erstatt, sett noe foran, mat inn, mat ut eller behold grensesnittet: avgjort per system, så det første prosjektet bærer liten risiko.
Ingen leverandørinnlåsing. Bruk dine egne databaser, din egen sky, din egen infrastruktur.
En modell bygges på tre til tjue minutter fra en beskrivelse. En applikasjon er i drift på 10 til 40 minutter.
Rå tilgang er ikke nok
Hvert eneste KI-prosjekt i større virksomheter treffer den samme veggen. Agenten når frem til dataene, men tre systemer er uenige om hva en kunde er, ingen har skrevet ned hvilke felter den får endre, og tilgangene lever i integrasjonskode og i hodene på folk. Det er ikke et datakvalitetsproblem. Det er manglende kontekst.
Med rå datatilgang
- Agenten gjetter hva feltene betyr
- Definisjonene varierer mellom systemer
- Tilganger reimplementeres for hver konsument
- Hver ny app eller agent er et nytt integrasjonsprosjekt
- Ingen logg over hva agenten gjorde eller hvorfor
Med Dataceen
- Entiteter, relasjoner og regler defineres én gang
- Samme betydning i API-et, SDK-en, søkeindeksen og MCP-verktøyet
- Tilganger hentes fra katalogen din og gjelder likt for mennesker og agenter
- Nye konsumenter gjenbruker modellen i stedet for å bygge den på nytt
- Hver endring registreres som en hendelse du kan spille av på nytt og revidere
Sikkerhet og kontroll
Virksomheten din kontrollerer hvor Dataceen-forvaltede data lagres.
Høres det kjent ut?
Fire situasjoner vi hører hver uke. Alle ender på samme måte: beskriv dataene én gang, så genererer Dataceen det situasjonen trenger.
«Ledelsen vil ha KI på dataene våre. Sikkerhet sier fortsatt nei.»
Begge har rett. Dataceen eksponerer dataene dine gjennom MCP-verktøy som arver rollene og tilgangene i katalogen din — hvert kall logget og reviderbart. KI-agenter får tilgang på samme måte som mennesker: trygt.
Start fra: et databaseskjema eller en API-spesifikasjon.
«Å svare på kundenes spørsmål krever tre systemer og to telefonsamtaler.»
Beskriv dataene én gang. Dataceen genererer API-et, søket og KI-verktøyene som svarer på spørsmål i vanlig språk fra levende data — under tilgangene som allerede finnes.
Start fra: API-spesifikasjoner, skjemaer eller dokumenter.
«Portalen er utsatt to ganger. Hver integrasjon prises i måneder.»
Fra modellen din genererer Dataceen systemet — API-er, typede SDK-er, dokumentasjon og ferdige instruksjoner for kodeagenter. Systemet dere har utsatt blir dager med arbeid, ikke kvartaler.
Start fra: det systemene deres allerede eksponerer.
«Ærlig talt? Vi er lei av KI-pitcher. Vi trenger å få integrasjoner, tilganger og revisjon på plass.»
Greit nok. Dataceen krever ingen KI-strategi: genererte API-er, finkornet tilgangskontroll og et komplett hendelsesspor løser hverdagsproblemet. Og hvis dere en dag vil ha KI på dataene deres — er det allerede trygt.
Start fra: et databaseskjema, eller til og med en PDF som beskriver domenet.
Klar for å forenkle dataarkitekturen din?
Bygg en første modell fra en beskrivelse, og avgjør per eksisterende system hvordan det passer inn.